人型ロボットやフィジカルAIの開発競争で、ロボット本体やAIモデルと並んで重要になっているのが「学習データ」です。
生成AIは、インターネット上に蓄積された文章、画像、動画などを大量に学習できます。一方、現実世界で物をつかみ、運び、組み立て、道具を使うロボットには、それだけでは足りません。「カップをどこからつかむのか」「どの方向へ腕を動かすのか」「どの程度の力を加えるのか」「失敗したときにどう修正するのか」といった、物理世界での行動と結果を学習する必要があるからです。
このため現在のフィジカルAI開発では、高性能なロボットを作るだけでなく、ロボットに学習させるデータを、どのように高品質かつ大量に作るかが重要な競争領域になっています。
中国でもこの動きは顕著です。2026年には、データ収集センターや訓練場の整備だけでなく、WRC(世界ロボット大会)などの展示会でデータ収集装置そのものの存在感が高まっています。ロボット産業を見るうえで、「何台作ったか」だけではなく「どうやってロボットを賢くするのか」を理解する必要が出てきました。
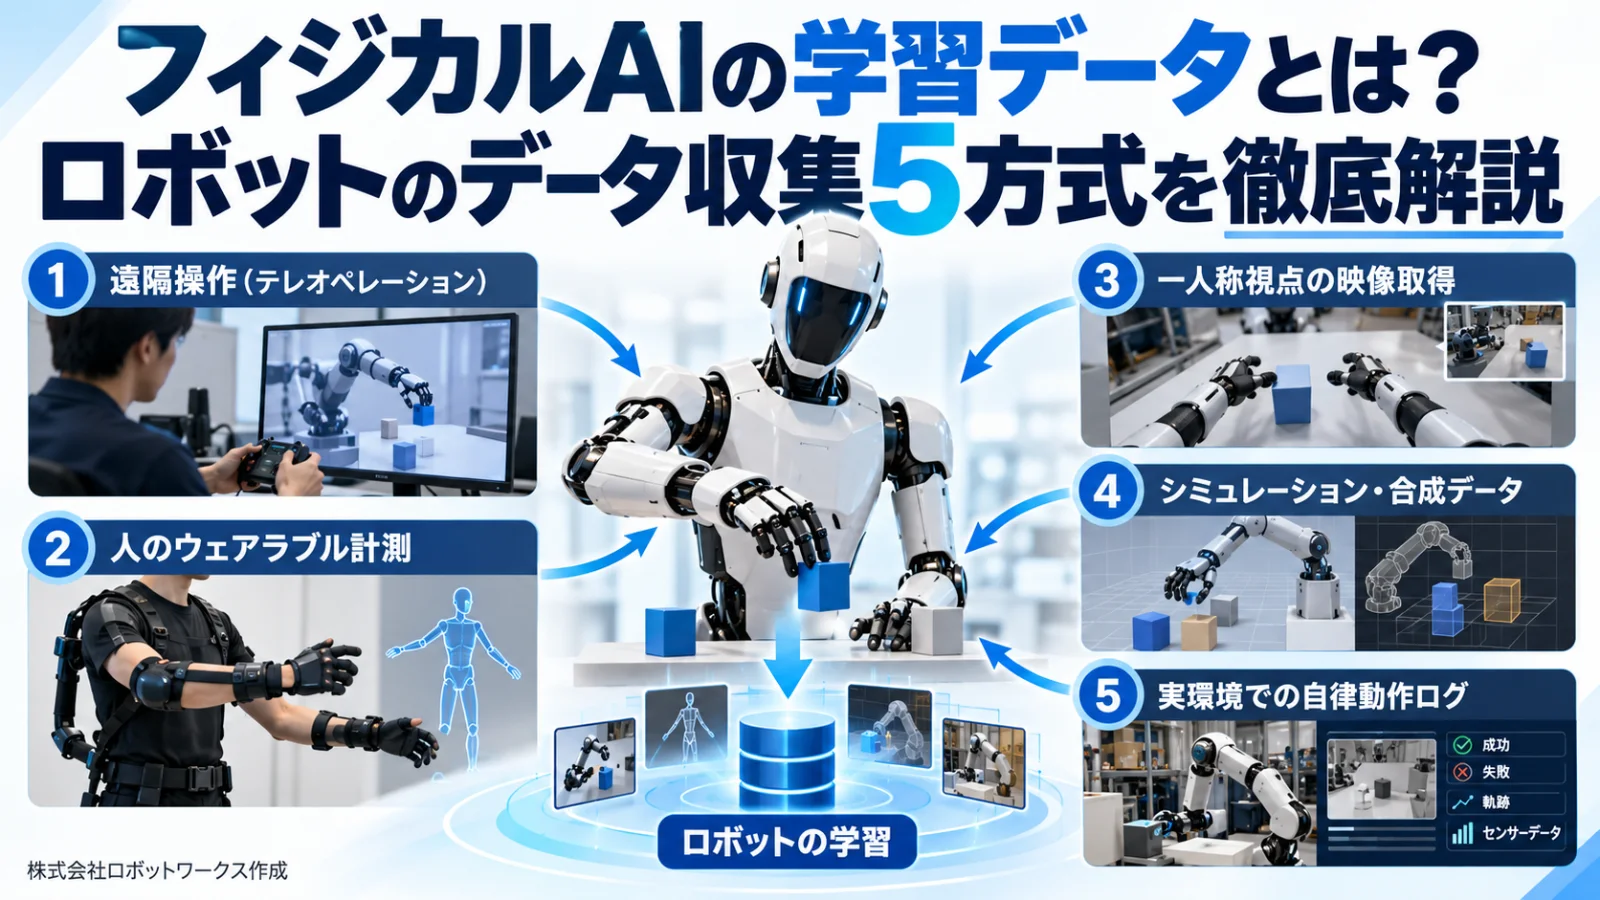
本記事では、フィジカルAIのデータ収集方法を、理解しやすいよう大きく5つの方式に整理します。
- 実機データ収集
- UMIなどのロボット本体を使わない操作データ収集
- 人体・手部モーションキャプチャ
- 一人称視点データ
- シミュレーション・合成データ
どれか一つが優れているわけではありません。それぞれ取得できる情報、コスト、大規模化のしやすさ、実際のロボットへの転用のしやすさが異なります。
この記事では、5方式の違いから、フィジカルAI時代に「良いデータ」とは何か、中国でなぜデータ関連産業が成長しているのか、日本企業にどのような事業機会があるのかまで整理します。
情報基準日:2026年9月24日
そもそもフィジカルAIの「学習データ」とは何か
人間に「テーブルの上にある赤いカップを棚へ移してください」と頼んだ場合、人間であればカップを見つけ、距離を判断し、腕を伸ばし、適切な力でつかみ、棚まで運べます。
ロボットに同じ仕事を学習させる場合、単純な動画だけでは十分ではありません。その瞬間にロボットが何を見ていたのか、どのような姿勢だったのか、どの関節をどの方向へ動かしたのか、その結果としてカップがどう動いたのか、といった情報の対応関係が重要になります。
代表的なデータには、RGBカメラ画像、深度画像、ロボットの関節角度・関節速度、手先の位置と姿勢、グリッパーやロボットハンドの状態、力覚・触覚、言語によるタスク指示、実行したAction、成功・失敗などの結果が含まれます。
重要なのは、「ロボットが何を見たか」というObservation(観測)と、「何をしたか」というAction(行動)、さらに「その結果、世界がどう変化したか」という結果を結び付けることです。
特にVLA(Vision-Language-Action)モデルでは、映像や言語を理解するだけでなく、その理解をロボットの具体的なActionへ変換しなければなりません。そのため、一般的な映像データとロボット学習用データには大きな違いがあります。
なぜロボットの学習データを集めるのは難しいのか
生成AIとフィジカルAIの大きな違いの一つが、データを取得するためのコストです。
文章や画像であれば、すでにインターネット上に膨大なデータがあります。しかし、ロボットが工場でコネクターを挿したり、家庭で衣類を畳んだり、商品を棚へ陳列したりしたときの「映像とActionが対応したデータ」は、自然には大量発生しません。
実機ロボットで収集する場合には、ロボット本体だけでなく、遠隔操作をするオペレーター、センサー、通信設備、計算機、データ保存設備、作業場所、保守担当者などが必要です。ロボットが故障したり、転倒したりすれば、当然データ収集も止まります。
さらに見落とされやすいのが「リセット」です。例えばロボットが10個の商品を箱へ入れるタスクを終えた後、次のデータを取るためには商品を再び元の位置へ戻す必要があります。実験環境を何度も元に戻す作業まで含めると、100台のロボットを並べたからといって単純に100倍のデータが生産できるわけではありません。
こうした問題から、現在のフィジカルAI業界では、「実機ロボットだけに依存せず、どうやって大量の学習データを作るか」が大きな研究・事業テーマになっています。
この記事のテーマについて、貴社の状況に合わせて個別にご相談いただけます。
中国の現地調査・企業視察・製品調達・導入検討など、目的に合わせて必要な支援を組み立てます。
通常1〜2営業日以内にご返信します。依頼内容が固まっていない段階でも構いません。
フィジカルAIのデータ収集5方式は何が違うのか
ここから5方式を詳しく見ていきますが、その前に全体像を整理します。
5方式の違いを見る際に重要なのは、誰が動くのか、ロボット本体が必要か、Actionをどこまで直接取得できるか、大量収集しやすいか、実世界とのギャップがどの程度あるかという視点です。
| 方式 | データの主な取得元 | ロボット本体 | 大規模化 | 特徴 |
|---|---|---|---|---|
| 実機データ | 実際のロボット | 必要 | 難しい | 対象ロボットに最も近い |
| UMI系 | 人間+操作装置 | 原則不要 | 比較的しやすい | 人間の作業をロボット操作データへ変換 |
| モーションキャプチャ | 人間の身体・手 | 不要 | 中程度 | 人間の自然な動作を精密に取得 |
| 一人称視点 | 人間の作業映像 | 不要 | しやすい | 日常・現場データを大量収集しやすい |
| シミュレーション・合成 | 仮想環境・生成モデル | 不要 | 非常にしやすい | データを大量生成できる |
これは優劣のランキングではありません。求めるタスク、ロボットの構造、必要な精度、センサー構成、コストによって適した方式は変わります。
実際のフィジカルAI開発では、これらを単独で使うというより、複数方式を組み合わせる方向へ進んでいます。
方式① 実機データ収集|実際のロボットを動かして学習する
最も直接的なのが、実際のロボットを現実世界で動かしながら取得する「実機データ」です。
人間がロボットを遠隔操作し、物をつかむ、置く、運ぶ、組み立てるといったタスクを実行します。その間にカメラ映像、ロボットの関節角度、手先の位置、グリッパーの開閉、力覚・触覚などを同期して記録します。
実機データの最大のメリットは、最終的に動かしたいロボット自身からデータを取得できることです。
人間とロボットでは、腕の長さ、関節構造、可動範囲、手の構造が異なります。一方、対象ロボットをそのまま操作して取得したデータであれば、そのロボットが実際に動ける範囲や、カメラの位置、モーター特性、接触時の振る舞いまでデータに反映できます。
実機データはどのように取得するのか
代表的な方法の一つが、主従アームによる遠隔操作です。人間が操作する「マスター側」の小型ロボットアームを動かすと、作業側の「スレーブ側」ロボットが追従します。
この方式を使った代表例がALOHAです。
ALOHAは、双腕操作用の低価格なオープンソースハードウェアシステムとして2023年に発表されました。ACT(Action Chunking with Transformers)と組み合わせた研究では、バッテリー挿入や容器を開けるタスクなど6種類の実世界タスクについて、約10分のデモデータから80〜90%の成功率を報告しています。
その後のMobile ALOHAでは、双腕に移動台車を組み合わせ、調理、収納、エレベーターへの乗車など、移動を伴うタスクへ対象が広がりました。各タスク50回のデモと既存のALOHAデータを組み合わせた学習も行われています。
もう一つの方法がVRを使った遠隔操作です。オペレーターがヘッドセットを装着し、ロボットの視点を見ながらコントローラーやハンドトラッキングでロボットを操作します。人型ロボットでは、全身モーションキャプチャやデータグローブを組み合わせるケースもあります。
実機データの課題
最大の問題はコストとスケーラビリティです。
ロボット本体の購入費に加え、オペレーター、保守、充電、作業スペース、タスクのリセットなどが必要になります。また、1種類のロボットで取得したデータが、構造の異なる別のロボットへそのまま利用できるとは限りません。
そのため実機データは非常に重要である一方、「すべてのデータを実機で集める」方法だけでは、フィジカルAIの大規模学習に必要な量を確保しにくいという問題があります。
方式② UMI|ロボット本体なしで操作データを集める
実機データのコスト問題に対する有力なアプローチの一つが、UMIです。
UMIはUniversal Manipulation Interfaceの略で、2024年のRobotics: Science and Systems(RSS)で発表されました。特徴は、データ収集時に対象となるロボット本体を必要としないことです。
UMIでは、人間がカメラ付きの手持ちグリッパーを使って実際の作業を行います。カップをつかむ、物を移動する、引き出しを開けるといった作業を人間自身が行い、そのときの映像、グリッパーの状態、軌道などを記録します。
ロボットよりも人間の方が素早く移動でき、さまざまな現場へ入り込めるため、データ取得の場所を増やしやすいことが大きな特徴です。
UMIの公式プロジェクトでは、手持ち式の平行二指グリッパーとGoProカメラなどを組み合わせてデータを収集しています。多様な人間デモから学習したポリシーが、新しい環境や物体へゼロショットで汎化できることも検証しています。
なぜUMIが注目されるのか
例えば100カ所の工場から作業データを集めたい場合、100カ所すべてに人型ロボットを配置するのは現実的ではありません。
一方、小型のデータ収集装置であれば、工場、店舗、家庭などへ持ち込み、人間が普段行っている作業を収集できます。「ロボットをデータのある場所へ持っていく」のではなく、「軽量な収集装置を人間のいる場所へ持っていく」という発想です。
これはフィジカルAIのデータを大規模化するうえで大きな意味を持ちます。
UMIにも課題がある
ただし、「ロボットなしで集めたデータだから、あらゆるロボットへ使える」という意味ではありません。
人間とロボットでは腕の長さや可動範囲が違います。二指グリッパーと五指のデクステラスハンドでも構造は大きく異なります。
そのため、人間が実行した軌道をロボットが実行可能なActionへ変換する必要があります。UMIの重要性は単に「ロボットを使わない」ことだけではなく、収集した人間操作データとロボット実行時の差をどう縮めるかという点にもあります。
さらに近年は、二指グリッパーだけでなく、人間の指に装着する外骨格などを使ってデクステラスハンド向けデータを集める方式も研究されています。今後、ロボットハンドの自由度が高くなるほど、この領域の重要性も高まると考えられます。
方式③ モーションキャプチャ|人間の身体や手の動きをロボットへ移す
3つ目は、人間そのものの動きを記録するモーションキャプチャです。
映画やゲーム制作で広く使われてきた技術ですが、人型ロボットやフィジカルAIでも、人間の身体動作を学習させるためのデータ取得手段として利用されています。
大きく分けると、外部カメラを使う光学式、身体へIMUなどを装着する慣性式、さらに指や手首を細かく計測する手部モーションキャプチャがあります。
光学式モーションキャプチャ
光学式では、作業空間の周囲へ複数のカメラを設置し、人間や工具などに付けたマーカーの位置を複数方向から追跡します。
高精度な3次元位置を取得しやすいため、ロボット研究でも利用されています。一方で、カメラを設置・校正する必要があり、遮蔽や死角への対応も必要になります。
中国のNOKOV(度量科技)も、人型ロボットやフィジカルAI向けに、データ収集、模倣学習、遠隔操作、動作リターゲティング、Sim-to-Real検証などへモーションキャプチャを利用するソリューションを展開しています。公式情報では、人間、工具、ロボットに加え、映像、力覚など複数のデータを同期する構成も示しています。
慣性式モーションキャプチャ
慣性式では、身体各部にIMUなどの小型センサーを付け、加速度や角速度から人体の姿勢を推定します。
光学式のように広範囲へカメラを配置する必要がないため、工場内や屋外などで人が移動しながら作業する場合にも使いやすいことが特徴です。一方で、センサーのドリフトや全体位置の推定などには別の工夫が必要になります。
手部モーションキャプチャ
ロボットが精密作業をする場合、腕の位置だけでは足りません。指一本一本の姿勢、手首の向き、物体との接触関係が重要になります。
Stanford UniversityなどによるDexCapは、その代表例の一つです。SLAMと電磁式の手部モーションキャプチャ、周囲の3D観測を組み合わせ、人間の手首・指の動きと環境情報を収集します。そのデータをDexILによってロボットのデクステラス操作へ移す研究が行われました。
モーションキャプチャの課題
最大の課題は「人間の動き」と「ロボットが実行できる動き」が一致しないことです。
人間の身体はロボットとは関節数も骨格も可動範囲も異なります。そのため、人間の動きを対象ロボットの構造へ変換する「リターゲティング」が必要になります。
また、軌道だけでは接触を完全には表現できません。コネクターの挿入、ネジ締め、柔軟物の操作などでは、「どこへ動いたか」に加え、「どれだけの力で押したか」「いつ接触したか」といった力覚・触覚情報も重要になります。
方式④ 一人称視点データ|人間が仕事をする映像から学ぶ
フィジカルAIのデータを大規模化する方法として、特に注目されているのが一人称視点データです。
英語ではEgocentric DataやFirst-Person Dataと呼ばれます。人間が頭部カメラ、スマートグラス、ヘッドバンド、胸部カメラなどを装着し、実際に作業をしている様子を、人間自身の視点から記録します。
この方式が注目される最大の理由は、人間がすでに世界中で毎日膨大な物理作業をしているからです。
料理、清掃、製造、物流、商品陳列、修理、農作業など、人間の活動をそのままデータ化できれば、実機ロボットだけでは到底集められない規模の実世界経験を取得できる可能性があります。
Ego4Dに見る一人称視点データの規模
代表的な一人称視点データセットがEgo4Dです。
Ego4D公式サイトでは、9カ国・74地点から3,670時間を超える一人称視点動画を収録していると説明しています。家庭、職場、屋外、余暇など幅広い日常活動が含まれ、一部には音声、3D環境情報、視線、ステレオ映像なども付随しています。
こうしたデータは、人間がどのような場面で何を見て、次に何をするのかを学習するうえで非常に有用です。
ただし、一人称動画を大量に集めれば、そのままロボットを動かせるわけではありません。
動画には「人間が何をしているか」は映っていますが、ロボットが必要とする関節指令、手先軌道、グリッパー開閉、接触力などが直接記録されているわけではないからです。
そのため、一人称映像から人間の手、物体、身体、作業内容などを理解し、さらにロボットが実行できるActionへ変換する必要があります。
映像だけからマルチモーダル収集へ
一人称視点データも、単純な動画撮影から進化しています。
頭部カメラにIMU、深度カメラ、マイクなどを追加したり、データグローブや触覚センサーと組み合わせたりすれば、人間が「何を見ていたか」だけでなく、「どのように手を動かし、何に触れたか」まで記録できます。
中国でも、一人称視点を含む人間由来データをロボット学習へ利用する企業が増えています。Lightwheel(光輪智能)は現在、EgoSuiteとしてマルチモーダルな一人称人間データを提供し、SimReadyによる仮想環境、RoboFinalsによる評価と合わせて「World・Behavior・Evaluation」の3層でフィジカルAIのデータ基盤を構築しています。
一人称視点方式は非常に大きな可能性を持つ一方、「何時間録画したか」と「何時間の有効なロボット学習データを作れたか」は同じではありません。データの切り出し、Action推定、品質評価まで含めて考える必要があります。
方式⑤ シミュレーション・合成データ|仮想世界でデータを増やす
5つ目が、現実世界だけに頼らず、シミュレーションや生成AIを使ってデータを作る方法です。
仮想環境であればロボットを壊す心配がなく、GPU上で多数のロボットを並列に動かすこともできます。物体の配置、照明、背景、摩擦などを変更しながら、実世界では集めにくい状況まで大量に生成できることが大きなメリットです。
ただし「合成データ」と一言で言っても、現在はいくつか異なるアプローチがあります。
物理シミュレーターでロボットを動かす
最も分かりやすいのが、3D空間へロボットと物体を配置し、物理エンジンの中でタスクを実行させる方法です。
中国発のRoboTwin 2.0は、双腕ロボット操作を対象としたシミュレーション基盤で、公式ドキュメントでは50を超える双腕タスクと5種類のロボットプラットフォームを対象に、データ収集と評価を行えるとしています。
こうした環境では、同じタスクでも物体の位置や環境条件を変化させ、大量の学習データを作ることができます。
現実世界をシミュレーションへ再現する
一方、単に見た目のきれいな3Dモデルを作るだけでは不十分です。
机や箱の形が合っていても、重量、摩擦、重心、衝突形状、関節構造などが現物と違えば、仮想環境で学習したロボットが実世界では動かない可能性があります。
LightwheelはSimReadyとして、形状だけでなく、ロボットシミュレーションで必要となる物理情報を持ったアセットの整備を進めています。同社は、現実世界の摩擦や接触などを測定してシミュレーションへ反映することを、Sim-to-Real Gapを縮小するための重要なインフラと位置付けています。
世界モデルでデータそのものを生成する
さらに新しい方向が、世界モデルを使ってロボットの学習データそのものを生成する方法です。
NVIDIAのIsaac GR00T-Dreamsでは、CosmosのWorld Foundation Modelを利用してロボットの作業動画を生成し、Inverse Dynamics Modelによって動画から3Dの「Neural Trajectory」を抽出します。その軌道をロボットの学習へ利用する仕組みです。
従来の3Dシミュレーションでは、人間が環境やタスクを構築する必要がありました。世界モデルを利用する方式では、生成AIによって条件の異なる作業映像を大量に作り、そこからロボットが利用可能なActionへ変換する方向が模索されています。
最大の課題はSim-to-Real Gap
シミュレーションや世界モデルには大きな可能性がありますが、最大の問題は現実世界とのギャップです。
現実には、摩擦、重量、重心、柔らかさ、ケーブルの変形、紙や布のしわ、センサーノイズ、モーターの癖など、無数の物理条件があります。
映像として自然に見えることと、物理的にロボットが実行できることは同じではありません。
そのため、合成データだけですべてを解決するというより、シミュレーションで大量に学習し、最後に実機データや実機評価によって現実とのギャップを埋める構成が重要になります。
5方式は競合するのではなく、組み合わせて使う
ここまで5方式を分けて説明しましたが、実際には明確に分離されているわけではありません。
一人称カメラにデータグローブを組み合わせれば、一人称視点とモーションキャプチャの融合になります。UMIで集めた人間データをシミュレーションで増やすこともできます。実機ロボットが失敗した場面だけを人間が遠隔操作で修正し、その介入データを再学習へ利用することも考えられます。
今後重要になるのは、例えば次のような循環です。
人間から大量のデータを取得する
→ シミュレーションや世界モデルで拡張する
→ ロボットを学習させる
→ 実機で評価する
→ 失敗しやすい場面を特定する
→ 必要なデータだけ追加収集する
→ 再学習する
このループを高速で回せる企業ほど、少ないコストでロボットの能力を改善しやすくなります。
つまりフィジカルAIのデータ競争は、「大量のデータを持っている会社が強い」という単純な構図ではありません。
自社の現場データをフィジカルAIに活かせるか、検討したい方へ
株式会社ロボットワークスでは、中国のデータ収集企業・モーションキャプチャ企業・シミュレーション企業の動向をまとめた資料をご用意しています。製造・物流現場の作業データをフィジカルAIへ活用する際の論点整理にもご活用いただけます。
「10万時間のデータ」だけでは価値を判断できない
フィジカルAI業界では、「○万時間のデータを収集した」「○万時間のデータを保有している」といった数字を目にする機会が増えています。
しかし、時間数だけでデータの価値を比較することには注意が必要です。
例えば1万時間あっても、同じ物体を同じ環境で繰り返し持ち上げているだけなら、追加で得られる学習情報は限定的かもしれません。一方で、100時間でも、多様な環境、異なる物体、成功と失敗、人間による修正などが含まれていれば、モデルにとって価値の高いデータになる可能性があります。
データを見る際には、少なくとも次の点を確認する必要があります。
- どのタスクを収集したのか
- どのロボットを想定しているのか
- どのようなセンサー情報が含まれるのか
- ObservationとActionが同期しているのか
- 成功だけでなく失敗や途中修正を含むのか
- 環境、物体、作業者にどの程度の多様性があるのか
- 異なるロボットへ転用できるのか
- 学習後の実機性能が実際に改善したのか
最終的に重要なのは「何時間集めたか」ではなく、そのデータを追加することでモデルの能力がどれだけ改善したかです。
失敗データや人間の介入も重要になる
ロボットの学習では、成功した模範動作だけでなく、失敗や修正の過程にも大きな価値があります。
例えばロボットがカップをつかもうとして少し位置を外し、滑ったあとに再び手を動かして持ち直したとします。その過程には、「正常な成功動作」だけを何度も記録していても得られない情報があります。
将来的には、ロボットが自律動作している大部分の時間について人間が操作するのではなく、失敗しそうな瞬間だけ人間が介入する方式も重要になると考えられます。
自律実行、失敗、人間による介入、復旧、再学習を一つのデータループにできれば、人間が最初から最後まで遠隔操作し続けるより、データ生産効率を高められる可能性があります。
中国では「ロボット本体」から「データ生産」の競争へ
中国のフィジカルAI産業を継続的に見ていると、競争の焦点が少しずつ変化していることが分かります。
初期には、「人型ロボットが歩ける」「転倒しても立ち上がれる」「ダンスができる」といった本体性能のデモが注目されました。しかし、実際の工場や店舗へロボットを導入する段階では、「歩けるか」だけでなく「仕事を覚えられるか」が重要になります。
そのため、中国ではロボットメーカーだけではなく、データ収集機器、モーションキャプチャ、データ収集センター、シミュレーション、世界モデル、データ管理、モデル評価といった周辺領域が新しい産業カテゴリーになりつつあります。
2026年のWRCを現地で見ると、完成したロボット本体だけでなく、データ収集や学習を支える技術も重要な展示テーマになっています。
関連記事:
WRC 2026 世界ロボット大会 現地レポート|出展373社で何が変わったか
また、ロボットに限らず、人間の行動や現実世界から得られる「リアルデータ」がAI時代の新しい資産になっている点も重要です。
関連記事:
中国のリアルデータ×AIとは?AIグラス・AIトイ・LBE・家政ロボット4事例
データファクトリーの役割も変わっていく
中国各地では、人型ロボットや具身智能向けの「データ収集センター」「訓練場」「データファクトリー」が設置されています。
初期には、数十台から数百台のロボットを並べ、人間が遠隔操作する形が分かりやすいデータ生産モデルでした。しかし今後は、「何台のロボットを並べているか」だけでは差別化しにくくなると考えられます。
実機データだけでなく、UMI、一人称視点、モーションキャプチャ、シミュレーション、世界モデル、自律実行中のデータ、人間の介入データなどを統合し、最終的にモデル性能を改善できるかが重要になるからです。
データファクトリーも、単に人海戦術でロボットを遠隔操作する「データ製造工場」から、モデルを評価し、弱点を発見し、必要なデータを設計・生産するデータエンジンへ進化していく可能性があります。
日本企業にとって重要なのは「現場の仕事をデータとして見る」こと
ここからは株式会社ロボットワークスの考察です。
日本企業にとって、この変化は「中国でロボットのデータ収集企業が増えている」という話だけではありません。
製造、物流、小売、食品、建設、医療、介護など、日本企業が長年蓄積してきた現場作業そのものが、フィジカルAI時代にはデータ資産になる可能性があります。
製造現場だけを考えても、組立、検査、コネクター挿入、配線、ネジ締め、部品供給、不良品への対応、異常時の復旧など、熟練者が日常的に行っている物理作業があります。
現在、その多くは「仕事」として実行されているだけで、ロボットが学習できる形式では保存されていません。
ここにスマートグラス、一人称カメラ、UMI、モーションキャプチャなどを組み合わせれば、これまで消えていた人間の作業経験をデータ化できる可能性があります。
実際に株式会社ロボットワークスが深セン視察を支援した案件でも、子どもの運動データを将来のフィジカルAI基盤モデルへ活用できないか、といった仮説検討が行われています。
関連記事:
深セン視察2日間で新規事業の仮説を検証|飲食ロボットと運動データ
「とりあえず動画を撮る」では不十分
一方で、「フィジカルAI時代にはデータが重要だから、工場へカメラを付けて動画を撮ろう」と考えるだけでは不十分です。
重要なのは、最初に「将来どの作業をロボットに学習させたいのか」を考えることです。
その作業には映像だけで十分なのか。手指の情報が必要なのか。力覚が必要なのか。作業対象物の状態変化まで記録すべきなのか。失敗や熟練者による修正を取得すべきなのか。目的によって必要なセンサーも収集方法も変わります。
考え方としては、
ロボットに覚えさせたい仕事
→ 必要なモデル能力
→ 必要な学習信号
→ 必要なセンサー
→ データ収集方法
という順番で逆算することが重要です。
「大量に撮影したが、モデル学習には使えなかった」という状況を避けるためにも、データ収集自体を目的化しないことが重要になります。
よくある質問
- フィジカルAIとは何ですか?
-
フィジカルAIとは、AIがロボット、自動運転車、ドローンなどを通じて現実世界を認識し、判断し、物理的な行動を行う技術領域です。
生成AIが主にデジタル空間で文章や画像を生成するのに対し、フィジカルAIではAIの判断が実際の物理世界でのActionにつながります。
- 実機データとは何ですか?
-
実際のロボットを現実環境で動かし、その際のカメラ映像、関節状態、Action、センサー情報、環境の変化などを記録したデータです。
対象ロボットの物理的な特性を含んだ高品質なデータを得やすい反面、ロボット、オペレーター、保守、作業場所などが必要なため、大規模化にはコストがかかります。
- UMIとは何ですか?
-
UMIはUniversal Manipulation Interfaceの略で、人間がカメラ付きの手持ちグリッパーなどを使って実際の作業を行い、そのデータをロボット学習へ利用する方式です。
ロボット本体を収集現場へ持ち込まなくても、現実世界の操作データを取得できることが大きな特徴です。
- モーションキャプチャとUMIは何が違いますか?
-
モーションキャプチャは主に人間の身体や手そのものの動きを計測します。UMIは、人間がロボット操作に近いインターフェースを操作し、視覚情報と操作軌道を同時に取得することに重点があります。
ただし実際には両者の境界は完全には分かれておらず、一人称カメラ、モーションキャプチャ、操作デバイスなどを組み合わせる方式も増えています。
- 一人称視点の動画だけでロボットを学習できますか?
-
一人称動画は、人間が何を見て何をしているかを学習するうえで有用ですが、そのままロボットのActionになるわけではありません。
手や物体の位置、動作、接触関係などを推定し、さらに対象ロボットが実行可能なActionへ変換する必要があります。
- シミュレーションだけでロボットを学習できますか?
-
タスクによりますが、現時点では実世界のデータや実機評価との組み合わせが重要です。
シミュレーションは大量のデータを低コストで作れる一方、摩擦、重量、変形、センサーノイズなど現実世界との違いがあります。この差をどのように縮めるかがSim-to-Realの重要な課題です。
- データ収集センターとは何ですか?
-
人型ロボットやフィジカルAIのモデル学習に必要なデータを組織的に収集する施設です。
中国では「数据采集中心」「具身智能训练场」「数据工厂」など複数の呼称が使われています。実機ロボットの遠隔操作だけでなく、今後は人間データ、シミュレーション、モデル評価などを組み合わせた施設へ変化していくと考えられます。
まとめ|フィジカルAIの競争は「ロボットを作る」から「経験を作る」へ
フィジカルAIの競争は、ロボット本体の性能だけを競う段階から、そのロボットにどのような「経験」を与えるかという段階へ移っています。
データ取得方法は、大きく実機データ、UMI、モーションキャプチャ、一人称視点、シミュレーション・合成データの5系統に整理できます。それぞれ取得できる情報、コスト、大規模化のしやすさ、ロボットへの適用性が異なります。
重要なのは、どれか一つの方式が勝つことではありません。
低コストで大量に取得できる人間由来データ、スケールしやすいシミュレーション・合成データ、そして現実世界との最後のギャップを埋める実機データを組み合わせ、学習と実機評価の結果から必要なデータを追加していく。このループそのものが、今後のフィジカルAI開発における重要な競争力になると考えられます。
中国では、完成したロボット本体だけでなく、データ収集機器、モーションキャプチャ、シミュレーション、世界モデル、モデル評価など、その周辺に新しい企業群が形成されています。
日本企業にとっても、自社の現場で日々生み出されている人間の作業を「フィジカルAIの学習データ」という視点で捉え直すことが、新しい事業機会につながる可能性があります。
参考情報
UMI — Universal Manipulation Interface
UMI公式プロジェクト
ALOHA — Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware
ALOHA公式プロジェクト
DexCap — Scalable and Portable Mocap Data Collection System for Dexterous Manipulation
Robotics: Science and Systems掲載ページ
Ego4D
Ego4D公式サイト
RoboTwin 2.0
RoboTwin 2.0公式ドキュメント
NVIDIA Isaac GR00T-Dreams
NVIDIA公式解説
Lightwheel(光輪智能)
Lightwheel公式サイト
NOKOV(度量科技)
NOKOV 人型ロボット・フィジカルAI向けモーションキャプチャ
中国フィジカルAI・ロボットの調査、視察、PoCをご検討の方へ
株式会社ロボットワークスでは、中国・深センを拠点に、フィジカルAI、人型ロボット、データ収集、シミュレーション、ロボット基盤モデルなどの企業・市場調査を行っています。
「中国のフィジカルAI関連企業を比較したい」「自社の工場や業務データをフィジカルAIへ活用できるか検討したい」「データ収集企業やロボット企業を現地で確認したい」といった場合には、企業調査、現地ヒアリング、企業視察、PoC候補企業の選定まで支援可能です。